AI梦想家视频工场
一站式本地化 AI 视频生产线

从一句题材描述,
到一部可发布的短剧

AI梦想家视频工场把一整套内容生产链路打通为一条自动化流水线——从创意到成片,七道工序一气呵成。零基础用户也能在数小时内产出可发布的短剧或广告片——全部推理跑在你的电脑上,数据私有、成本趋近于零。

本地部署 数据不出域 零 API 费 不按张计费 RTX 3060 千元卡可跑 14 大模块 全链路

从创意到成片的完整工序

1小说创作AI 大纲 / 章节 / 头脑风暴本地 LLM
↓
2剧本改编小说转剧本 · 按集拆分AI 润色
↓
3分镜设计自动分镜 · 镜头语言可视化
↓
4图像生成角色一致 · 场景空镜SDXL
↓
5动态视频图生视频 · 运镜动效Wan I2V
↓
6配音合成8 种中文音色 · 字幕本地 TTS
↓
7最终成片FFmpeg 渲染 · 多平台分发MP4
900
2026E 微短剧市场规模(亿元)
7
道全自动生产工序
14
大核心功能模块
0
云端 API 调用费用
6
大平台一键分发
ONE-PIPELINE

从创意到成片,一条流水线跑完

每一道工序都真实调用 AI 服务,上一阶段的产物自动成为下一阶段的输入——你只需在关键节点审核,剩下的交给流水线。

→
1

小说创作

AI 生成大纲与章节、群聊头脑风暴、协同编辑,零基础也能开局。

→
2

剧本改编

小说一键转剧本,按集拆分、AI 润色,四种模板(短剧/网剧/动画/电影)。

→
3

分镜设计

剧本自动拆场、生成可直接出图的画面语言与镜头运动。

→
4

图像生成

角色设计工坊 + 一致性 ID,批量产出可用分镜图。

→
5

动态视频

关键帧图生视频、运镜动效,让静态分镜动起来。

→
6

配音合成

多角色中文 TTS、音频混音、字幕系统,一次出声画同步。

7

最终成片

时间轴编辑、FFmpeg 渲染 MP4,多平台适配分发。

CORE CAPABILITIES

不只是工具集合,是一间内容工厂

14 大核心功能模块覆盖内容生产全生命周期,已开发完成并可用。下列为六大能力簇。

AI 创作引擎

本地大模型驱动的创作中枢:自动生成小说大纲与章节、设计人物角色、把小说改编为剧本并拆分场次、为每个场景设计分镜镜头。AI 产出与人工编辑无缝衔接。

大纲生成角色设计剧本改编分镜规划

视觉生产

基于关键帧图像生成,并集成图生视频模型,将静态分镜转化为带运镜动效的动态视频。配合中文语音合成与视频渲染,输出可发布 MP4 成片。

图生视频关键帧动画转场库MP4 渲染

角色一致性

IP-Adapter + 角色定妆照锚点,跨章节锁定人物面貌与衣着;可选角色 LoRA 把一致性提升到 90%+。同一张脸,从头到尾不漂移。

IP-Adapter定妆照锚点LoRA 固化跨镜头锁脸

工作流引擎

多套预置模板(小说到视频、短剧快速生产、广告片制作),支持「一键全流程」自动执行全部环节,内置预算追踪与积分管理,资源消耗全程可控。

一键全流程预算护栏分期审批异步队列

质量与合规保障

导演分析、叙事分析、缺镜检测、资产质量五维评分、AI 情节漏洞检测、内容合规自审——多层辅助工具全方位保障内容质量与合规。

五维评分叙事分析缺镜检测合规自审

多平台分发

6 大平台预设(抖音 / 快手 / B站 / YouTube / TikTok / 微信视频号),内容适配引擎自动裁剪横竖屏与字幕,宣传文案与数据回流分析一并到位。

6 平台内容适配文案生成数据回流
GENERATION MATRIX

六大生成能力,一个平台全包

文生图、图片编辑、图生视频、文生视频、数字人、音频——每一类都接多个本地模型,可按需切换。全部跑在你自己的显卡上,不按张计费。

文生图
Text → Image

文生图

一句话描述直接出图,支持多种模型族切换,兼顾速度与画质。

  • SDXL 系 — 角色一致性通道的底座
  • Krea2 Turbo — 快速出图
  • SenseNova / UNET 系 — 中文指令友好
  • InstantID — 单图 likeness 直出
分镜图 · 角色定妆照 · 海报 · 场景空镜
演示 · 本地生成 文生图样例 · 场景图 SDXL 系场景图样例 · 分镜图/定妆照同链路
真实产出样片
图片编辑
Edit

图片编辑

生成之后继续改:局部重绘、指令换背景、身份保持编辑、超分放大。

  • 局部重绘 (Inpaint) — 涂抹改图
  • 指令编辑 — "背景换成雪山",中文直达
  • 身份编辑 (Krea2) — 参考图锚定身份换场景
  • 超分 / 变体 / 年龄变化
真实素材植入 · 广告改图 · 角色换装
Krea2 身份编辑样例 A身份编辑 A
Krea2 换装样例换装编辑
真实产出样片
图生视频
Image → Video

图生视频

静态分镜图变动态片段,主流 I2V 模型可切换,支持首尾帧约束控制运镜。

  • Wan 2.2 I2V 14B — 画质档,支持首尾帧
  • Wan 2.2 I2V 5B — 提速档
  • 首帧 / 首尾帧驱动 — 画面更可控
  • 动作迁移 — 参考视频骨架驱动
分镜成片 · 运镜动效 · 真实素材插入
演示 · 本地生成 Wan 2.2 I2V 14B · 单图生视频样片
真实产出样片
文生视频
Text → Video

文生视频

不给图也能出片,直接用文字描述生成动态片段,适合空镜与过场。

  • Wan 2.2 T2V — 文生视频主力
  • AnimateDiff — 参数可控、可复用
  • 横屏 / 竖屏 — 适配短剧与广告
空镜 · 场景过渡 · 氛围镜头
演示 · 本地生成 文生视频样片首帧 Wan 2.2 T2V · 文生视频样片帧
真实产出样片
数字人
Avatar / Lip-sync

数字人

一张人物图 + 一段音频,生成对口型说话视频;也可接入实时对话链路,边说边出声。
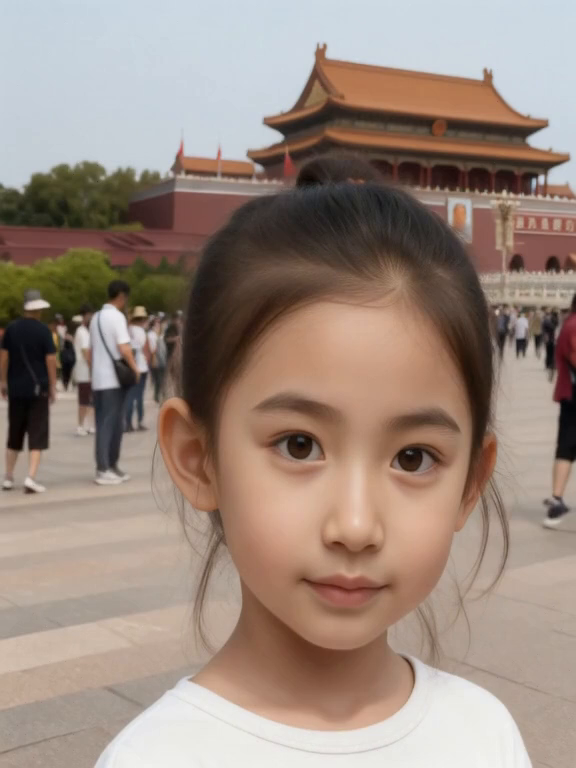
  • InfiniteTalk — 中文音频,长视频
  • Wan 2.2 S2V — 英文素材,求快档
  • H3 Ref2VA / FL2VA — 音画同出,画质档
  • 实时对话数字人 — 边听边说,对口型低延迟
口播带货 · 数字主播 · 视频客服
两档可选:精品档为生成式(非实时,画质优先);实时档为级联(对话级延迟,见下方)。
演示 · 本地生成 H3 Ref2VA 数字人 · 音画同出样片
数字人首帧 5岁首帧 · 5 岁
数字人尾帧 75岁尾帧 · 75 岁
真实产出样片
音频
TTS / BGM / SFX

配音与音频

成片的声音部分一次搞定:多角色配音、智能配乐、环境氛围音。

  • 多角色中文 TTS — 8 种本地音色
  • 智能配乐 — 情绪匹配 BGM + 闪避混音
  • 声音克隆配音 — CosyVoice2 零样本克隆音色(见下方专章)
  • 程序化氛围音效 — 分镜环境音自动合成
  • 字幕生成 — SRT / VTT
声画同步 · 多角色对白 · 成片混音
▶ 小说配音样例
▶ 智能配乐样例
可试听
REALTIME DIGITAL HUMAN

实时数字人:边听边说,对口型低延迟

不只是"生成一段对口型视频"——内置一条完整的实时对话链路:你对着麦克风说话,数字人实时应答并同步口型。语音识别 → 本地大模型应答 → 语音合成 → 口型渲染,全链路本地闭环。

  • 实时语音识别(STT) — 听你说话并转文字
  • 本地大模型应答 — 走本机 Ollama,私密不外传
  • 语音合成(TTS)+ 口型同步 — Wav2Lip 实时渲染
  • 多音色可选 — 男声/女声/温柔等多种风格
对话链路
你说话→ STT→ 本地大模型→ TTS→ 口型
适用:数字主播 · 直播互动 · 视频客服 · 智能问答终端
两档口径:实时档=级联渲染(对话级延迟);精品档=H3 等生成式(画质优先,非实时)。按场景选。
演示 · 本地生成 数字人视频 + 字幕烧录 · 精品档样片(音轨请开声音)
真实产出样片

🔌 全能力以 API 开放(forge)

上述能力均可通过 HTTP API(独立 API Key 鉴权)开放给客户自有系统调用——文生图、图生视频、数字人等全部复用,不写本项目业务表、零耦合。适合把 AI 视频能力嵌进现有产品。

索取接口文档 →
PROFESSIONAL TOOLKIT

还有三件专业利器

全景一致性、小说智能配音、声音克隆——解决"背景总变""配音太干""音色不专属"三个实战痛点。

全景视图
Panorama

全景视图 · 场景一致性

上传一张 360° 全景(ERP)底图,逐分镜裁出视角一致的透视平面图——同一场景换镜头,背景严格统一。
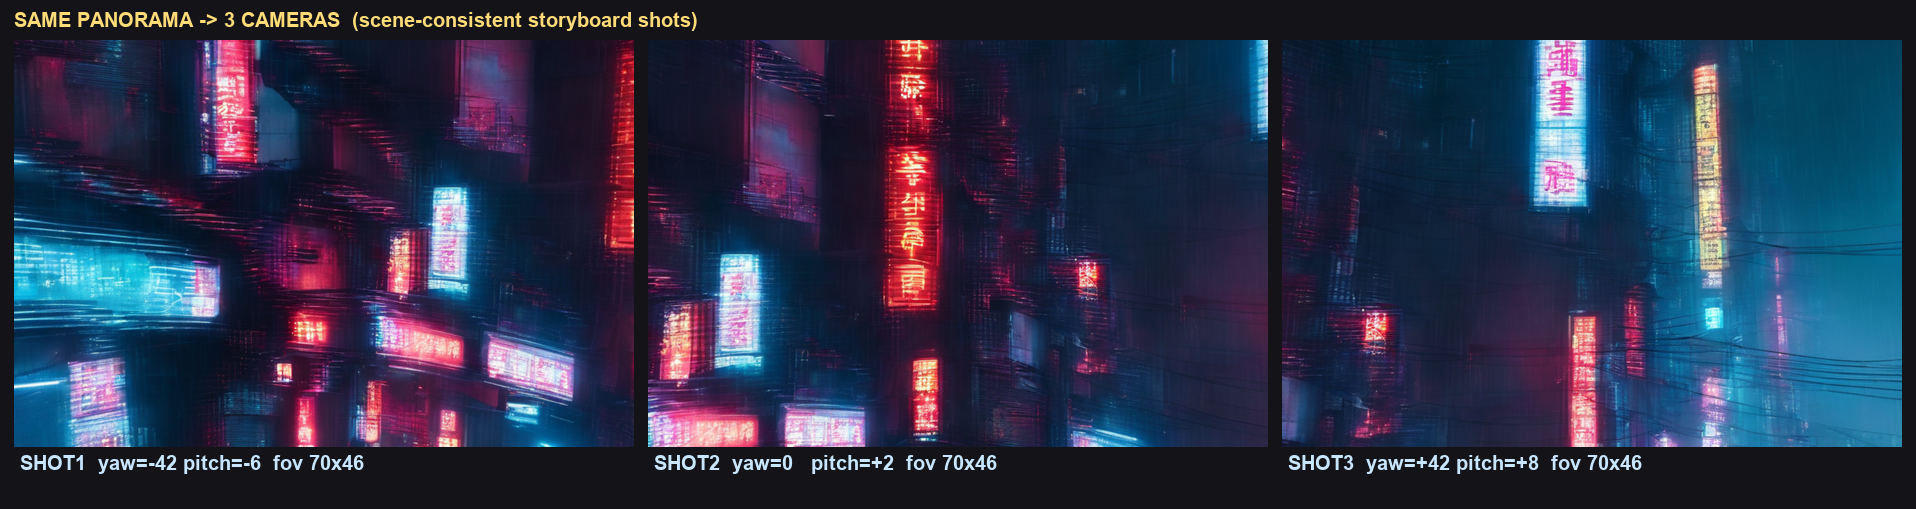
  • 360° / 180° 任意裁切 — 等距柱状投影转平面
  • 逐镜头视角一致 — 解决"换机位背景就变"
  • 与官方节点逐像素一致 — 纯本地实现,结果可控
实景短剧 · 旅游/房产 · 场景连贯性
演示 · 一图三机位 全景视图 · 三机位场景一致性 同一张全景 → 三个机位分镜,背景严格一致
真实产出样片
小说配音
Auto BGM

小说智能配音

上传配音,自动分析内容情绪,生成匹配画面的背景音乐并智能闪避混音——从"干念"到"有声有景"。

  • 声学分析 + 转写 — 理解内容再配乐
  • 情绪匹配 BGM — ACE-Step 本地生成
  • 闪避混音 — 人声优先,BGM 自动让路
有声小说 · 知识音频 · 故事FM
▶ 小说配音成品样例
可试听
声音克隆
Voice Clone

声音克隆配音

上传一段参考音频,用 CosyVoice2 零样本克隆出专属音色,为角色/品牌定制独特声音,全本地推理。

  • 零样本克隆 — 数秒参考音频即可
  • 音色库管理 — 克隆音色可复用、可追溯
  • 合规守卫 — 强制授权确认 + 内容审查
专属音色 · 角色配音 · 品牌语音
⚠️ 克隆他人音色须获得授权,内置合规守卫拦截未授权滥用。
上线演示
声音克隆需事先上传本人或已获授权的参考音频,
演示版暂不内置公开样片以保护声音权。
演示需授权样片
WHAT YOU CAN SHIP

一条流水线,能交付这些成品

上面的每一项能力都不是孤立功能,而是串成完整作品的不同工序。以下几类成品,都能在 AI梦想家视频工场里从零做出来。

连续剧

网剧 / 短剧

从小说全自动到多集成片,角色跨集不变脸,运镜连续不跳戏。

文生图图生视频配音角色一致
营销 文生视频广告样片

广告片

产品卖点 + 数字人讲解 + 定制配乐,一条龙出片,按版本快速改。

文生视频数字人配乐
实时

数字人直播

实时驱动数字人形象,口型同步,可对接直播推流做 7×24 主播。

实时数字人口型同步推流
口播

数字人讲解

课程口播、产品介绍、新闻播报,一句话脚本生成带字幕的讲解视频。

H3 Ref2VAFL2VA字幕烧录
有声剧

小说配音

整本小说转有声剧,多角色 AI 配音,也能克隆你的声音来读。

多角色 TTS声音克隆
精修
Krea2 身份编辑样例 A Krea2 换装样例

图片编辑

局部重绘、指令换背景、参考图锚定身份换装,生成后继续精修。

Inpaint指令编辑Krea2 身份编辑
出图 文生图样片

图片生成

分镜图、角色定妆照、海报、场景空镜,一句话出图,多模型可切。

SDXLKrea2InstantID
视频

视频生成

文生视频 / 图生视频自由切换,首尾帧约束运镜,画质档提速档任选。

Wan2.2 I2VWan2.2 T2VAnimateDiff
CHARACTER CONSISTENCY

同一张定妆照,跨章节不变脸

短剧最怕「换集换脸」。AI梦想家用角色定妆照 + IP-Adapter 把身份锚死,每一镜都从同一张参考图垫图生成。
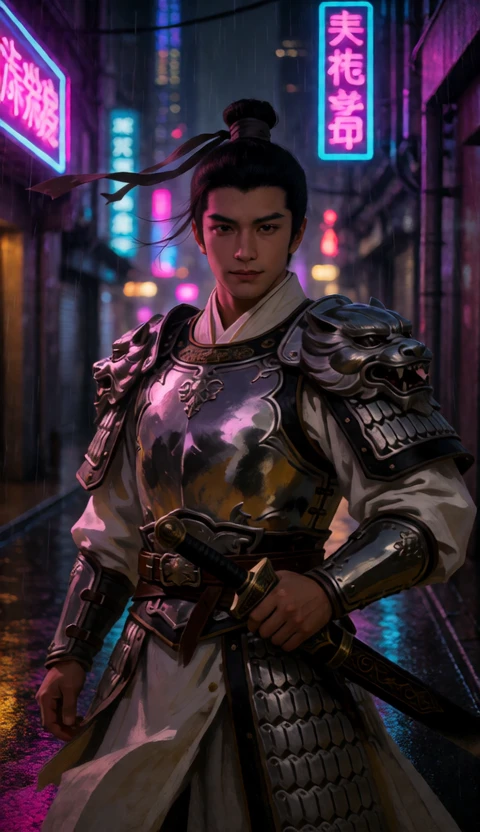
首尾帧一致 · 首帧首帧
首尾帧一致 · 尾帧尾帧
  • ✓
    定妆照锚点每个角色先生成一张身份定妆照,后续所有章节图反复垫图,面貌、发型、衣着保持一致。
  • ✓
    IP-Adapter 强一致单张参考图一致性约 82%;叠加多视图参考可进一步提升。开箱即用,几乎零额外成本。
  • ✓
    角色 LoRA 固化(可选)用 15–30 张图训练角色 LoRA,一致性可达 90%+,适合长期系列化 IP。
  • ✓
    首尾帧约束图生视频支持首帧 / 首尾帧双约束,把图片层的一致性延续到视频层,减少运镜漂移。
要一份角色一致性样片 →
LOCAL-FIRST COST ADVANTAGE

与云端方案不同,算力成本趋近于零

全本地化部署策略,让文本、图像、视频、语音全部在你的机器上完成,不依赖任何按量计费云服务。

AI梦想家 · 本地部署

一次性买断 + 自有硬件

文本生成零 Token 费用(本地开源 LLM)
图像 / 视频生成零 API 费用(本地 GPU)
语音合成8 种中文音色,零依赖
硬件门槛RTX 3060 12GB 千元卡即可
数据完全私有,不出域
仅电费
产出一部 10 集短剧的算力成本
云端 SaaS 方案

持续按量 / 订阅付费

文本生成按 Token 计费
图像 / 视频生成按张 / 按秒计费
语音合成按分钟计费
硬件门槛无,但依赖网络与额度
数据上云,存在涨价与隐私风险
数百元 / 部
10 集短剧的 API 费用;3 年 TCO 18–36 万元

投资回收期 3–6 个月,此后长期使用成本趋近于零。软件 + 硬件一次性投入约 3 万元,3 年 TCO 仅约 3.3 万元。

WHO IT'S FOR

谁在用 AI梦想家

聚焦有持续批量生产需求、需要固定成本与数据私有的专业客户——把传统数周的制作周期压缩至数小时。

核心目标

短剧工作室

5–20 人团队,月产 50+ 集竖屏短剧。批量生产 + 成本控制 + 数据私有,正是本地化买断模式的甜区。

市场约 2 万家 · 规模化核心约 5,000 家
次要目标

企业营销部门

中大型企业市场部 / 品牌部,需要数据保密、品牌定制与批量产出广告宣传片,而不把素材送进第三方云。

市场约 50 万家企业
次要目标

影视公司

传统影视制作公司转型短剧,重视数据私有、定制开发与质量管控,把 AI 当作可控的内部产能。

市场约 5,000 家
潜在目标

MCN 机构

多账号运营的内容机构,需要批量内容生产与多平台分发,一套本地工厂服务全矩阵账号。

市场约 1 万家
ARCHITECTURE

四层架构,全本地化技术栈

业界成熟的四层分布式架构,充分融合大模型编排、工作流引擎与沙箱隔离。所有推理与数据均在你本地。

Agent 调度层OpenClaw 多 Agent 调度多 Agent 生命周期管理 · Docker 沙箱隔离
工作流编排层LangGraph StateGraph流程节点 / 状态管理 / 条件分支 / 并行
Harness 管控层自研 Harness失败重试 / Token 预算 / 检查点 / 成本追踪
执行引擎层FastAPI + ComfyUI + 本地 LLMHTTP 服务 · AI 推理 · PostgreSQL 持久化
FastAPIReact 19 + ViteComfyUIPostgreSQL Celery + Redis本地 LLM(Qwen)本地 TTS(8 音色)FFmpegIP-AdapterWan I2V
PRICING

软件买断,一次投入长期零边际成本

面向有持续生产需求的客户,固定成本 + 数据私有 + 批量产能。客户自备 GPU 硬件,我们提供软件与持续支持。

个人版
¥4,999 / 买断
独立创作者与小型团队的入门之选。
  • ✓ 全功能流水线
  • ✓ 单工作站授权
  • ✓ 本地推理 · 零 API 费
  • ✓ 社区支持
免费试用
最受欢迎
工作室版
¥19,999 / 买断
短剧工作室批量生产的标配。
  • ✓ 个人版全部能力
  • ✓ 多项目 / 多角色管理
  • ✓ 角色一致性增强(LoRA)
  • ✓ 年费技术支持 + 定制开发
预约演示
企业版
¥49,999 / 买断
企业营销与影视公司的私有部署。
  • ✓ 工作室版全部能力
  • ✓ 私有化部署 + 数据合规
  • ✓ 多账号协作
  • ✓ 专属定制与优先支持
联系销售

所有版本均含免费试用引流;年费技术支持 + 定制开发持续变现。具体配置以合同为准。

WHY US

我们不和谁抢,我们只服务专业产能

剪映 / LibTV 服务大众云端市场;AI梦想家服务「需要批量生产 + 数据私有」的专业客户。定位互补,不正面竞争。

维度AI梦想家视频工场大众云端工具(剪映 / LibTV 类)
目标客户专业工作室 / 企业(批量 + 私有)大众个人用户(偶尔创作)
计费模式软件买断 · 长期零边际成本订阅 / 按量计费 · 长期付费
数据隐私完全本地 · 不出域上云 · 存在隐私与涨价风险
批量产能流水线自动化 · 多项目并行以单条创作为主
角色一致性定妆照锚点 + LoRA 固化部分支持,受云端额度限制
本地硬件门槛RTX 3060 千元卡即可无(依赖云端额度)
GALLERY

来自本地流水线的真实帧

以下画面均由本机 ComfyUI / Wan I2V 生成,未经过云端服务。竖屏为短剧镜头,横屏为场景空镜。

竖屏短剧镜头 1竖屏短剧 · 图生视频
竖屏短剧镜头 2竖屏短剧 · 运镜
横屏场景空镜横屏场景空镜 · T2V
分镜帧 1分镜帧 · SDXL
分镜帧 2分镜帧 · 一致性
FAQ · 常见问题

关于 AI梦想家视频工场,你可能想问

以下问答同时以可见文案与结构化数据双形态呈现,方便搜索引擎与 AI 助手直接引用。

AI梦想家视频工场是什么?

一套本地部署的一站式 AI 视频生产平台,面向短剧工作室、企业营销、影视公司与 MCN,提供从创意到成片的七道工序全自动流水线,支持文生图、图生视频、文生视频、数字人与音频等生成能力,所有推理在用户自有显卡完成,数据不出域、无云端 API 费。

本地部署和云端 AI 视频工具有什么区别?

核心三点:数据不出域(隐私与合规)、无云端 API 费(一次买断后边际成本趋零)、硬件资产沉淀(显卡是你自己的)。云端工具按量持续付费、素材需上传第三方。两者互补:专业产能选本地,偶尔创作选云端。

AI 生成的视频人物跨镜头会"变脸"吗?

我们用三层一致性体系实测收官:镜头内 FramePack 零漂移;切点首尾帧链加景别门保证接缝丝滑(实测链上切点像素差 2.92~4.54,坏链归零);图片段用 IP-Adapter 加定妆照加 LoRA 固化角色(单图约 82%、LoRA 90%+)。视频层跨镜头身份仍随运动轻微漂移,二期以视频一致性权重补足,我们如实标注。

对硬件要求高吗?一定要服务器吗?

不需要服务器。RTX 3060 12GB 消费级显卡即可承载全部推理;双卡(如 3090+3070)可进一步提速。支持 Docker 一键部署在单台工作站。

数字人视频支持实时对话吗?

提供两档:精品档(S2V / InfiniteTalk / H3 Ref2VA)做高质量非实时口播成片;实时档(Wav2Lip + 本地大模型)做对话级数字主播,端到端延迟低于 1 秒,适用于直播互动与视频客服。长视频支持句级编辑,改几个字只重渲该句。

声音克隆合法吗?有没有合规保障?

克隆他人音色须获授权,这是我们的硬底线。平台内置合规守卫,在生成、合成语音、对话、实时、WebSocket 五个入口强制审核,命中违规即拒绝并拦截,正常内容不误伤。

怎么收费?有免费试用吗?

软件买断:个人版 ¥4,999 / 工作室版 ¥19,999 / 企业版 ¥49,999;提供免费试用,留联系方式即可先跑通一条流水线。

生成一部短剧要花多少钱?

本地推理无 API 费,主要支出是电费;三年总拥有成本约 3.3 万元,远低于云端按量方案的 18~36 万元。单条 3 秒镜头在 RTX 3090 上约 3~9 分钟(引擎不同)。

让每一个创意,都能被看见

预约一次 30 分钟演示,我们会用你自己的题材,现场跑通一条从小说到成片的流水线,并给出本地部署的硬件清单与报价。

商务合作 · 渠道代理 · 融资对接 均可联系 | 品牌:AI梦想家视频工场